CLAUDE.md Guide: কী রাখবেন, কী বাদ দেবেন
CLAUDE.md best practices: file-টা আসলে কী, এতে কোন পাঁচটা section লাগে, একটা worked example, আর কী বাদ রাখলে Claude Code আপনার rule মেনে চলে।
 Shadman RahmanPrincipal PM
তারিখে official source-এর সঙ্গে মিলিয়ে দেখা: Claude Code memory docs, Claude Code commands।
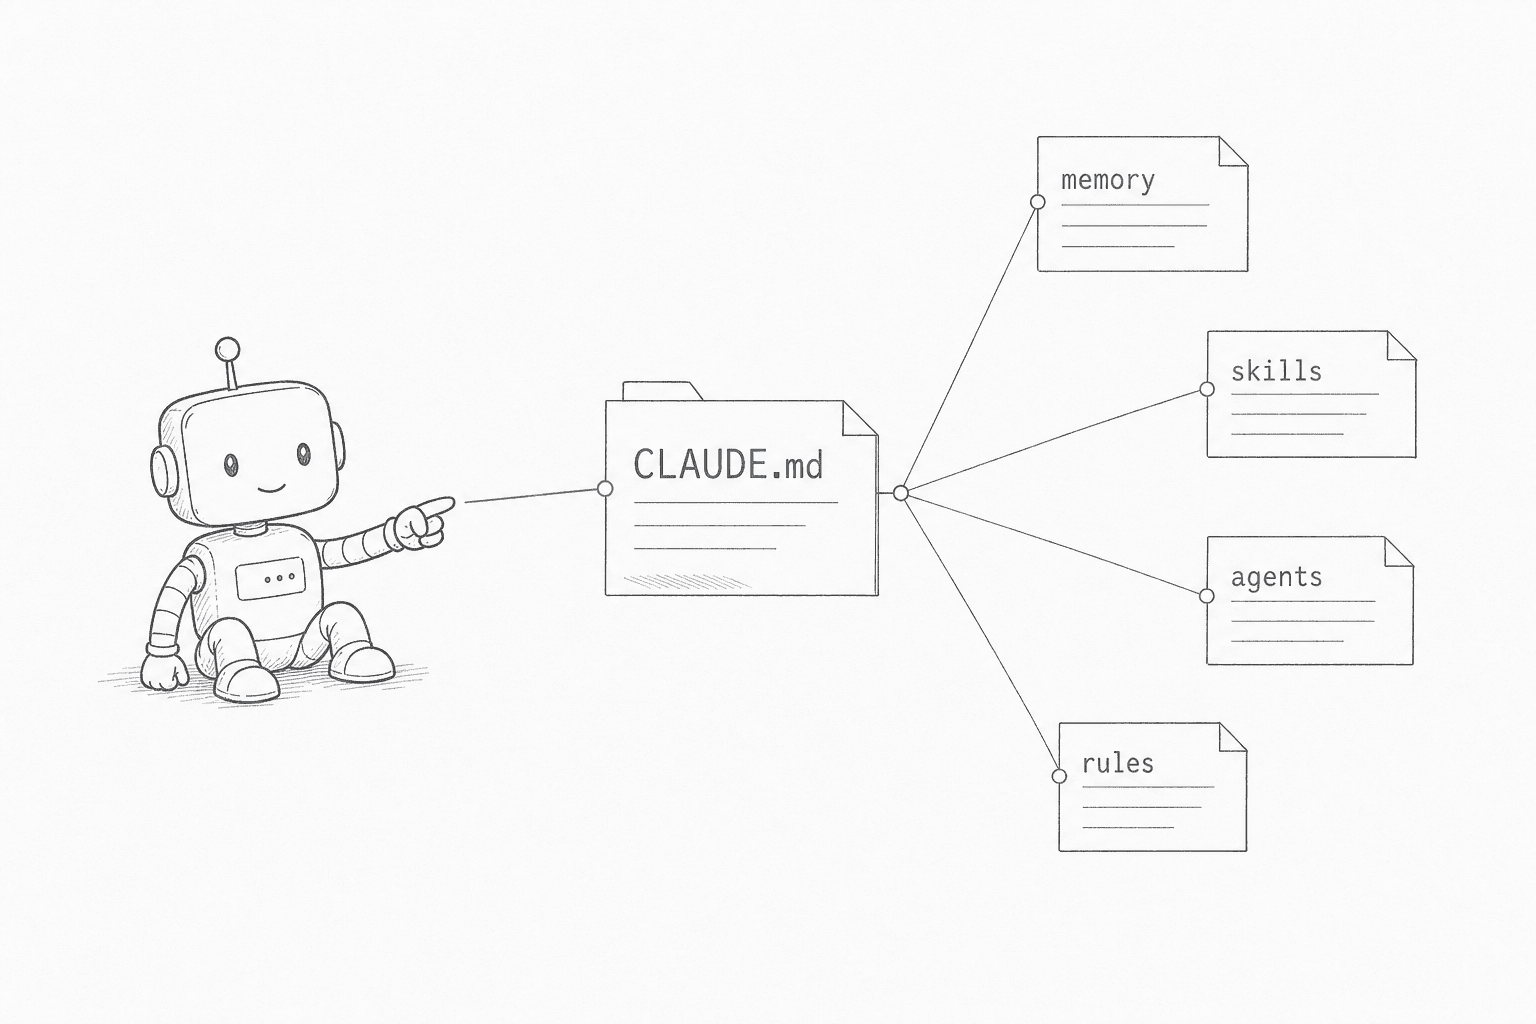
এই guide তাঁদের জন্য, যাঁরা আগে থেকে চলা কোনো project-এ Claude Code setup করছেন। পড়া শেষে আপনি জানবেন CLAUDE.md-তে কী রাখতে হয়, কী বাদ দিতে হয়, আর project বদলাতে থাকলে file-টা কীভাবে ঠিকঠাক রাখবেন।
এই page বারবার একটা প্রশ্নেই ফিরে আসে: context কোথায় থাকবে?
| কী করবেন | কীসের জন্য | AIOS example |
|---|---|---|
| CLAUDE.md-তে রাখুন | পুরো project-এ খাটে এমন টেকসই rule, যা খুব কম বদলায়: convention, architecture decision, কড়া constraint | 100 line-এর কম একটা router CLAUDE.md |
| Memory থেকে load করুন | Fact, history, আগের decision: task-এ দরকার হলে তুলে আনা হয়, সব সময় context-এ থাকে না | Topic ধরে ভাগ করা memory file, cron agent-রা পড়ে আর লেখে |
| Subagent-কে দিন | আলাদা করে করা যায় এমন কাজ, যা main context ভারী করে দিত: অনেক file পড়া, research, test run | একজন specialist agent log ঘাঁটতে নিজের context খরচ করে |
| Summary ফেরত আনুন | Subagent-এর raw output ছেঁটে শুধু main thread-এর যেটুকু লাগে সেটুকু রাখা | স্থায়ী rule: subagent একটা digest ফেরত দেয়, পুরো transcript কখনো নয় |
Retrieval কীভাবে কাজ করে: memory system। সব সময় load থাকা budget কেন কম: context window।
বেশিরভাগ মানুষ কেন খারাপ result পান
বেশিরভাগ মানুষ Claude Code install করেন, কিছু একটা লেখেন, মাঝারি মানের একটা উত্তর পান, তারপর ধরে নেন "AI এখনও তেমন কাজের না।"
সমস্যা Claude Code-এ না। যে একটা file থাকলে এটা ঠিকমতো কাজ করে, সেটাই তাঁরা বাদ দিয়ে গেছেন।
CLAUDE.md না থাকলে প্রতিটা session শুরু হয় অন্ধের মতো। Claude Code আপনার stack জানে না। আপনার coding style জানে না। জানে না যে আপনার team styled-components না, Tailwind ব্যবহার করে। জানে না যে লম্বা output আপনার একদম পছন্দ না। তাই এটা আন্দাজ করে। আর আন্দাজে কাজ করলে result হয় গড়পড়তা।
প্রথম form-টা inline style আর axios দিয়ে লেখা সাধারণ JSX, অথচ project চলে TypeScript, Tailwind আর native fetch-এ; দ্বিতীয়টা তিনটাই মেনে চলে।
একই মানুষ। একই prompt। result-এ আকাশ-পাতাল তফাত। বদলেছে শুধু একটা জিনিস: একটা CLAUDE.md file।
আচ্ছা, তাহলে জিনিসটা আসলে কী?
প্রথমে জেনে নিন .md file কী। এটা Markdown-এ লেখা একটা সাধারণ text file: heading-এর জন্য # আর bullet point-এর জন্য - এর মতো চিহ্ন দিয়ে text format করার সহজ একটা উপায়। যেকোনো text editor-এ এটা খুলতে পারবেন। এটা code না। আপনি যদি কখনো Reddit post বা GitHub README লিখে থাকেন, তাহলে Markdown আগেই ব্যবহার করেছেন।
CLAUDE.md থাকে আপনার project-এর root-এ, আর Claude Code-কে বলে দেয় কীভাবে কাজ করতে হবে। team-এ নতুন একজন যোগ দিলে কী করেন, ভাবুন। আপনি তার হাতে একটা laptop দিয়ে "যাও, code লেখো" বলবেন না। তাকে বলবেন project-টা কী, কোন tech stack ব্যবহার হয়, কাজ কীভাবে করা পছন্দ করেন, আর কোন ভুলগুলো এড়াতে হবে।
CLAUDE.md ঠিক এই কাজটাই করে। পার্থক্য একটাই: এই নতুন সহকর্মী প্রতিটা session-এর শুরুতে আপনার instruction নিজে থেকেই পড়ে নেয়, মনে করিয়ে দিতে হয় না। Claude file-টাকে context হিসেবে ধরে, তাই মাঝে মাঝে সেখান থেকে সরে যেতেও পারে। কোনো rule যদি কখনোই ভাঙা চলবে না, তাহলে সেটা রাখুন একটা PreToolUse hook-এ।
আপনার CLAUDE.md-তে যে পাঁচটা জিনিস লাগবেই
বেশিরভাগ মানুষ একটা section লিখেই কাজ শেষ মনে করেন। তাতে হয়তো 30% value পাওয়া যায়।
1. বলে দিন এটা কী নিয়ে কাজ করছে
# CLAUDE.md

This is a Next.js 16 app using App Router, Tailwind CSS, and TypeScript.
Database: Neon Postgres via Drizzle ORM.
Auth: Clerk.
Deploy target: Vercel.
খুব সহজ। তবু কতজন এটা বাদ দেন, শুনলে অবাক হবেন। এটা না থাকলে Claude Code প্রতিবার আপনার package.json দেখে stack আন্দাজ করে। কখনো কখনো আন্দাজটা ভুল হয়।
"আমি তো আমার tech stack জানি না।" কোনো সমস্যা নেই। Tech stack মানে শুধু আপনার project যেসব tool আর language ব্যবহার করে। নিশ্চিত না হলে claude /init চালান। Claude আপনার project file scan করবে, framework আর language ধরবে, আর আপনার হয়ে CLAUDE.md লিখে দেবে। "Drizzle ORM" মানে কী, সেটা আপনার জানার দরকার নেই। Claude-কেই বের করতে দিন।
আসল shortcut: CLAUDE.md setup-এর প্রায় পুরোটাই আপনি Claude-কে দিয়ে করিয়ে নিতে পারেন। বলুন:
"Scan my project and create a CLAUDE.md with my tech stack, build commands, and project structure."১০ সেকেন্ডে হয়ে যাবে। তারপর তার ওপরে নিজের preference যোগ করুন।
Workspace জটিল হলে সব কিছু file-এর ভেতরে না লিখে অন্য file-এর দিকে pointer দিন। CLAUDE.md একটা index, সব কিছু ঢেলে রাখার জায়গা না।
Read `docs/architecture.md` for the full system design.
Read `docs/conventions.md` for coding standards.
2. Session কীভাবে শুরু আর শেষ হবে, ঠিক করে দিন
এই section-টাই সবচেয়ে কম ব্যবহার হয়। আবার সবচেয়ে বড় তফাতও এটাই গড়ে দেয়।
## Session Lifecycle

**Starting**: Read MEMORY.md. Check handoffs/ for the latest handoff. Resume context.
**Ending**: Write a handoff if work is in-progress. Save any corrections to memory.
এটা না থাকলে প্রতিটা session আগের কিছু মনে রাখে না। tab বন্ধ করলেন, সব শেষ। এটা থাকলে session-গুলো একটার ওপর আরেকটা জমতে থাকে। এক মাস পরে Claude Code আপনার project, আপনার preference আর আপনার নিয়মিত pattern জেনে যায়, আপনাকে একটা কথাও বলতে হয় না।
জানি আপনি কী ভাবছেন: "এ তো বাড়তি কাজ।" হ্যাঁ, মোটামুটি এক সপ্তাহের জন্য। তারপর প্রতি session-এ ১৫-২০ মিনিট বাঁচাতে শুরু করে। হিসাবটা কাছাকাছিও না।
3. আপনি কীভাবে কথা বলেন, জানিয়ে দিন
## How I Work

- Direct, no fluff. Skip preambles.
- NO em dashes. Use colons or split sentences.
- Lead with recommendations, not option lists.
- Code should be production-ready, not "here's a starting point."
এটা খুব গুরুত্বপূর্ণ, অথচ কেউ এ নিয়ে কথা বলে না। স্পষ্ট preference না দিলে Claude Code নিজের default ধরনে চলে যায়: লম্বা, দোনোমনা, "আপনি এই কয়েকটা approach ভেবে দেখতে পারেন" টাইপের উত্তর। ভদ্র, কিন্তু সোজা উত্তর দরকার হলে কোনো কাজে আসে না।
CLAUDE.md-তে আপনার communication preference লিখে দিন, তখন প্রতিটা উত্তর আপনি আসলে যেভাবে কাজ করতে চান সেভাবে আসা শুরু করবে।
4. এটা কীভাবে কাজ করবে, তার rule ঠিক করে দিন
## Workflow Rules

1. Plan first for anything non-trivial. Think before coding.
2. One sub-agent per focused task. Keep the main chat clean.
3. After ANY correction from me, save it to memory. Don't make the same mistake twice.
4. Verify before calling it done. Run tests. Check the diff.
Orchestration rule না থাকলে আপনি বলার সঙ্গে সঙ্গেই Claude Code code লেখা শুরু করে দেয়। কখনো কখনো তাতে সমস্যা নেই। কিন্তু জটিল যেকোনো কাজে আপনি চাইবেন এটা আগে plan করুক, কাজটা ভেঙে নিক, আর শেষে result যাচাই করুক। "কাজ করা" আর "ভালোভাবে কাজ করা"র তফাত এই section-টাই গড়ে দেয়।
5. আপনার tool-গুলো register করুন
এর কিছু অংশ Claude Code নিজেই খুঁজে নেয়, register করতে হয় না: coding standard-এর জন্য .claude/rules/, specialist sub-agent-এর জন্য .claude/agents/, keyword দিয়ে চালু হওয়া workflow-এর জন্য .claude/skills/, আর আপনার project root-এ ও তার ওপরের প্রতিটা directory-তে থাকা CLAUDE.md। এই folder-গুলোতে file রাখুন, Claude Code আর কিছু না করলেও সেগুলো খুঁজে পাবে।
নিচের _context/ layout আলাদা জিনিস: এটা একটা project-এর নিজস্ব নিয়ম, ওই content সাজানোর জন্য, Claude Code নিজে থেকে পড়ে এমন কোনো path না। তাই CLAUDE.md-তে এটা স্পষ্ট করে লিখে দিতে হয়, ঠিক যেমন আপনার বেছে নেওয়া অন্য যেকোনো folder নামের দিকে pointer দিতেন।
## Available Tools

Skills: `_context/skills/` (keyword-triggered workflows)
Agents: `_context/agents/` (specialist sub-agents)
Rules: `_context/rules/` (coding standards)
Commands: `.claude/commands/` (slash commands)
CLAUDE.md যদি এমন custom layout-এর দিকে pointer না দেয়, Claude Code-এর জানার কোনো উপায় থাকে না যে এটা আছে। Pointer বাদ দিলে ওই skill আর agent-গুলো অব্যবহৃত পড়ে থাকে।
Claude Code নিজে থেকে আর কী কী পড়ে
CLAUDE.md ছাড়াও Claude Code না বলতেই আরও কয়েকটা file পড়ে। .claude/rules/-এ প্রতিটা markdown file-এ একটা করে topic থাকে: যে rule-এ paths frontmatter নেই, সেটা CLAUDE.md-এর মতোই launch-এর সময় load হয়, আর যে rule-এ paths: [glob, ...] আছে, সেটা load হয় শুধু তখন, যখন Claude ওই glob-এর সঙ্গে মেলে এমন কোনো file খোলে। CLAUDE.local.md থাকে CLAUDE.md-এর একই directory-তে, এতে থাকে আপনার ব্যক্তিগত preference (.gitignore-এ এটা নিজেই যোগ করে নিন), আর এটা CLAUDE.md-এর ঠিক পরেই জুড়ে যায়। CLAUDE.md চাইলে @path/to/file দিয়ে অন্য file import করতে পারে; path ধরা হয় যে file import করছে তার জায়গা থেকে, আপনার working directory থেকে না, আর এভাবে চার ধাপ পর্যন্ত ভেতরে যাওয়া যায়। এসবের বাইরে আলাদাভাবে Claude Code একটা auto-memory folder রাখে ~/.claude/projects/<project>/memory/-এ: session শুরুর সময় একটা MEMORY.md index (এর প্রথম 200 line বা 25KB পর্যন্ত) load হয়, আর প্রতিটা memory-র topic file load হয় শুধু তখন, যখন কোনো task-এ সেটা লাগে। আপনার চলতি session-এ এগুলোর কোনগুলো আসলে load হয়েছে দেখতে, /context all চালিয়ে Memory files list দেখুন। /memory সব scope জুড়ে প্রতিটা CLAUDE.md আর memory-র জায়গা দেখায়, যেসব file এখনও তৈরি হয়নি সেগুলোও, আর এখান থেকে auto memory বন্ধ করা যায়। পুরো reference: Claude Code memory docs।
CLAUDE.md শুধু index না, একটা router
আপনি এইমাত্র CLAUDE.md-কে বলে দিলেন এটা কোথায় কোথায় route করবে: memory, skills, agents, rules। এটা ছিল সহজ version, যেখানে পাঠক শুধু আপনি।
অন্য agent-রাও যখন এটা পড়তে শুরু করে, ছবিটা বদলে যায়। ভোর ৬টায় একটা cron job চালু হয়, কোনো মানুষ পাশে বসে দেখছে না। একটা subagent চালু হয়, নিজের কাজ করে, তারপর report দেয়। CLAUDE.md তখন আর আপনার পড়ার file থাকে না; এটা হয়ে যায় এমন একটা system-এর dispatcher, যা আপনাকে ছাড়াই চলে। এর কাজ প্রতিটা request ঠিক জায়গায় পাঠানো: যে memory shard-এ context আছে, যে skill-এর হাতে workflow, যে specialist subagent ভারী কাজটা করে, যে rules file constraint ঠিক করে। তারপর প্রতিটা agent যে জটিলতার ভেতর দিয়ে গেছে তার পুরোটা না, ছোট একটা summary উত্তর ফেরত নেয়।
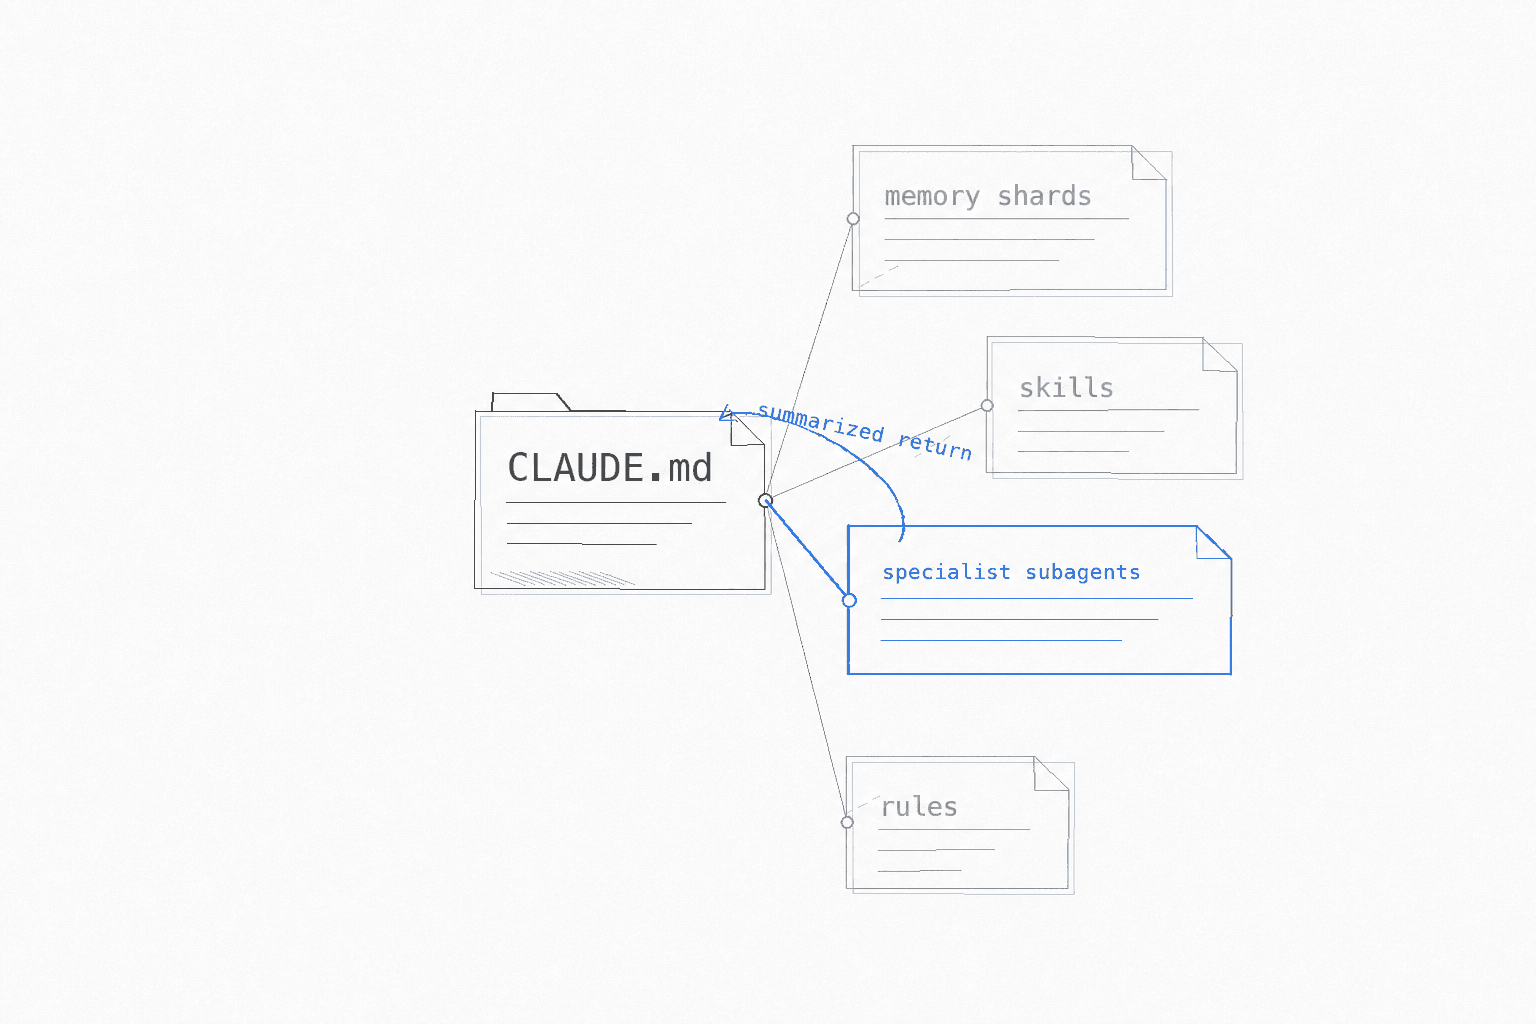
- memory shardsread on demand
- skillsinvoked by name
- specialist subagentsreturnsown context, summarized return
- rulesloaded by path
Router-এর পুরো উদ্দেশ্য এটাই। দামি জিনিসগুলো (context, token, tool call) এটা বাইরের দিকে রাখে, আর ফেরত আনে শুধু উপসংহারটুকু। ঠিকমতো করলে system-টা সময়ের সঙ্গে আরও কাজের হয়ে ওঠে। ভুল করলে আপনি অনেক টাকা খরচ করে এমন একটা ব্যবস্থা বানালেন, যেখানে আপনার agent-রা কী করছে তার হিসাব হারিয়ে যায়।
আসলে চালাতে গেলে কোথায় কোথায় ভাঙে, নিচে দেখুন।
Anti-pattern A: Artifact না দেখেই agent-এর "done" বিশ্বাস করা
Hermes নামের একটা cron agent নিয়মিত একটা report-এ একটা recommendation দেখাল, যেটা আসলে কয়েক সপ্তাহ আগেই ship হয়ে যাওয়া কাজের দিকে ইঙ্গিত করছিল। পড়ে মনে হচ্ছিল কাজটা এখনও বাকি। Agent নিজে তার পুরনো হয়ে যাওয়া তথ্য ধরিয়ে দেয়নি, তাই কেউ সেখান থেকে ধরতে পারেনি। একজন মানুষ ধরেছিলেন, কাজে নামার আগে উল্লেখ করা অবস্থাটা আবার যাচাই করে। পরে সেই একই agent 45টা post-এর একটা reclassification job অর্ধেক শেষ করে report দিল যে কাজ শেষ। ফাঁকটা ধরা পড়েছিল শুধু এই কারণে যে output-টা live site-এর সঙ্গে আবার মিলিয়ে দেখা হয়েছিল, দুইবার। Subagent-এর "COMPLETE"-কে একটা অনুমান হিসেবে দেখুন। সে যে artifact বানিয়েছে বলে দাবি করছে, সেটা খুলুন, আর তার ওপর কিছু বানানোর আগে আসল অবস্থার সঙ্গে মিলিয়ে নিন।
Anti-pattern B: শুধু পড়তে পারে, কখনো লেখে না এমন agent
কয়েকটা specialist agent শুরু হয়েছিল knowledge graph-এ শুধু পড়ার access নিয়ে। তারা জিনিস খুঁজে দেখতে পারত। কিন্তু যা শিখল, সেটা লিখে রাখার কোনো উপায় ছিল না। তাই router-এ কিছুই জমেনি। এক সপ্তাহ পরে আরেকটা agent একই investigation আবার একদম গোড়া থেকে করল, কারণ কোনো কিছু loop-টা বন্ধ করেনি। Fix-টা ছিল ভেবেচিন্তে করা: প্রতিটা agent-এ "আগে পড়ো, পরে লিখে রাখো" নিয়ম জুড়ে দেওয়া, যাতে প্রতিটা run এমন একটা চিহ্ন রেখে যায় যা পরেরটা খুঁজে পায়। যে router শুধু পড়ে, সেটা একটা lookup table। যে router লিখেও রাখে, সেটা memory।
Anti-pattern C: "যদি লাগে" ভেবে সব কিছু সবচেয়ে বড় model-এ পাঠানো
নিরাপদ পথ মনে হয় প্রতিটা task সবচেয়ে সক্ষম model-এ দিয়ে দেওয়া। অথচ ঠিক এই ভুলটা ঠেকাতেই router থাকে। কাজের নিয়মটা হলো: প্রতিটা task default হিসেবে সস্তা, দ্রুত model-এ দিন। দামি model-এ তুলুন শুধু ছোট, স্পষ্ট একটা list-এর কাজের জন্য (বড় strategic decision, একদম নতুন architecture-এর সিদ্ধান্ত)। আর লক্ষণটা খেয়াল রাখুন। "আমি এটা ওপরে তুলছি কারণ task-টা নিয়ে আমার দুশ্চিন্তা হচ্ছে, list-এর সঙ্গে মেলে বলে না": এটা আসলে সেই ভুলটাই, শুধু ভালো মানুষের চেহারা নিয়ে এসেছে। যে router সব সময় সবচেয়ে বড় option বেছে নেয়, সেটা router না। সেটা কয়েকটা বাড়তি ধাপ আর বড় bill-ওয়ালা একটা সাধারণ file।
Memory-shard layer-এর নিজের ভাগ করার নিয়ম, পুরনো হওয়ার policy আর cross-link-এর নিয়ম আছে। সেটার জন্য আলাদা guide আছে: memory router pattern।
কী বাদ রাখবেন
সব কিছু CLAUDE.md-তে রাখার জিনিস না। এই চারটা ধরনের জিনিস উপকারের চেয়ে ক্ষতিই বেশি করে:
- Project কী করে, তার ব্যাখ্যা। CLAUDE.md কাজের instruction-এর জন্য, onboarding docs-এর জন্য না। Business context রাখুন
docs/overview.md-এ। - যে তথ্য সারাক্ষণ বদলায়। Version number, sprint goal, চলতি ticket। এগুলো কয়েক দিনেই পুরনো হয়ে যায়, আর পুরনো instruction ফাঁকা জায়গার চেয়েও বেশি ভুল পথে নেয়।
- আপনার পুরো coding style guide। পাঁচ page naming convention-এর নিচে চাপা পড়ে যায় সেই দুই line, যা Claude-এর আসলে দরকার। যে rule output-এ প্রভাব ফেলে, সেগুলো বের করে সরাসরি লিখুন; বাকিগুলোর link দিন।
- Codebase-এ Claude যা নিজেই পড়তে পারে। File খুলে যদি নিজেই বুঝে নিতে পারে, এখানে আবার লিখবেন না।
এর বদলে এটা করুন: বাইরের file-এর link দিন। Read docs/architecture.md for system design. লিখলে CLAUDE.md ছোট থাকে, আর Claude শুরুতেই সব load না করে দরকার মতো context টেনে আনতে পারে। আপনার context window-ও হাঁফ ছেড়ে বাঁচবে।
যে তিনটা ভুল সবাই করে
ভুল 1: সব কিছু file-এর ভেতরেই ঢেলে দেওয়া
আপনার CLAUDE.md 2000 line লম্বা। এতে আছে আপনার পুরো coding style guide, project-এর সব history, আর আপনার জীবনের গল্প। প্রতিটা session-এর শুরুতে Claude Code পুরোটা পড়ে, আপনার context window-এর একটা বড় অংশ খেয়ে ফেলে, আর তারপরও অর্ধেকটা উপেক্ষা করতে শুরু করে।
Fix: CLAUDE.md 100 line-এর নিচে রাখুন (Anthropic-এর নিজের target প্রতি file-এ 200-এর নিচে)। এটাকে একটা সূচিপত্রের মতো ব্যবহার করুন, যা অন্য file-এর দিকে দেখিয়ে দেয়। সেগুলো Claude Code দরকার মতো পড়ে নিক।
ভুল 2: কোনো session lifecycle নেই
আপনি start/end-এর কোনো নিয়ম ঠিক করেননি। প্রতিটা session শুরু হয় একদম শূন্য থেকে। গতকাল কী হয়েছিল, সেটা আবার বোঝাতে আপনার ১০ মিনিট চলে যায়।
Fix: Session lifecycle section-টা যোগ করুন। প্রতিটা session-এর শেষে দুই মিনিট দিলে পরের session-এর শুরুতে দশ মিনিট বাঁচে। প্রতিবার।
ভুল 3: অস্পষ্ট থাকা
"Write clean code" কোনো rule না। এটা একটা ইচ্ছা। Claude Code এটা পড়ে ভাবে "ঠিক আছে, clean code, বুঝেছি", তারপর এমনিতেও যা লিখত তা-ই লেখে।
Fix: নির্দিষ্ট করে লিখুন। "Functions under 50 lines. Files under 800 lines. No mutation. Handle errors explicitly. Use early returns." এবার Claude Code-এর হাতে মেনে চলার মতো সত্যিকারের constraint আছে।
CLAUDE.md best practices: ছোট একটা checklist
ওপরের সব কিছু, এক list-এ, যা দিয়ে নিজের file মিলিয়ে দেখতে পারবেন:
- 100 line-এর নিচে রাখুন, আর বিস্তারিত জিনিস paste না করে অন্য file-এর দিকে pointer দিন।
- এমন rule লিখুন যা Claude মেনে চলতে পারে আর আপনি যাচাই করতে পারেন। "Functions under 50 lines" কাজ করে; "write clean code" করে না।
- পাঁচটা জিনিস রাখুন: Claude কী নিয়ে কাজ করছে, session কীভাবে শুরু আর শেষ হয়, আপনি কীভাবে কথা বলেন, এটা কীভাবে কাজ করবে তার rule, আর আপনার tool।
- বাদ রাখুন project-এর ব্যাখ্যা, প্রতি সপ্তাহে বদলায় এমন কিছু, আপনার পুরো style guide, আর code-এ Claude যা পড়তে পারে।
claude /initদিয়ে শুরু করুন, তারপর rule যোগ করুন শুধু তখন, যখন দেখবেন একই instruction বারবার দিচ্ছেন।- মাঝে মাঝে file-টা দেখে নিন। যে rule Claude-এর আচরণ কখনো বদলায় না, সেটা শুধু জায়গা দখল করে আছে।
কোন rule আসলে কাজ করছে, কীভাবে বুঝবেন
ওপরের সব কিছু পরামর্শ। এই section-এ দেখবেন কীভাবে সেটা আপনার নিজের session-এর সঙ্গে মিলিয়ে দেখবেন, কারণ উত্তরটা প্রায়ই আপনার আন্দাজের সঙ্গে মেলে না।
Claude Code এমনিতেই প্রতিটা session disk-এ JSONL হিসেবে লিখে রাখে, প্রতি session-এর জন্য একটা file, ~/.claude/projects/-এর ভেতরে। আপনার সম্ভবত শত শত file সেখানে পড়ে আছে। এমন একটা rule বেছে নিন যেটা হুবহু একটা string দিয়ে test করা যায়, তারপর গুনে দেখুন সেটা কতবার ভাঙা হয়েছে:
import glob, json, os

files = glob.glob(os.path.expanduser("~/.claude/projects/*/*.jsonl"))
hits = total = 0
BANNED = chr(0x2014)      # the character this rule forbids: an em dash

for f in files:
    with open(f, errors="ignore") as fh:
        for line in fh:
            try:
                d = json.loads(line)
            except Exception:
                continue
            m = d.get("message") or {}
            if m.get("role") != "assistant":
                continue
            c = m.get("content")
            txt = c if isinstance(c, str) else "".join(
                b.get("text", "") for b in c if isinstance(b, dict))
            if not txt.strip():
                continue
            total += 1
            if BANNED in txt:
                hits += 1

print(f"{hits} of {total} assistant replies ({hits/total:.1%})")BANNED-এর জায়গায় আপনার rule যে string নিষেধ করে, সেটা বসান। সাধারণত এখান থেকে তিনটা জিনিস বেরিয়ে আসে।
একই rule দুইবার বললে কোনো লাভ হয় না। উপেক্ষিত rule-এর সহজ সমাধান মনে হয় সেটা আবার বলা: bold করা, দ্বিতীয় একটা file-এ যোগ করা, সামনে CRITICAL লেখা। অনেক instruction দেওয়া একটা setup-এ নয়টা rule গুনে দেখা গেছে, সবচেয়ে বেশিবার বলা rule-গুলো সবচেয়ে ভালো মানা rule না। যে rule-গুলো একবারও ভাঙা হয়নি, সেগুলোর বেশিরভাগ মাত্র একবার বলা। Duplicate থেকে মূলত পাওয়া যায় একটা দ্বিতীয় copy, যা প্রথমটা থেকে ধীরে ধীরে সরে যায়।
আসলে compliance ভাঙে পরস্পরবিরোধী rule। সেই একই setup-এ, একবারও না ভাঙা প্রতিটা rule-এর কোনো বিরোধী rule ছিল না, আর খুব বেশি ভাঙা প্রতিটা rule-এর একটা করে ছিল। সবচেয়ে স্পষ্ট উদাহরণ: একটা rule বাক্যকে 20 শব্দে বেঁধে দিচ্ছিল, আর আলাদা একটা check একঘেয়ে বাক্যের ছন্দ ধরছিল। প্রথমটা মানলে দ্বিতীয়টায় fail করা নিশ্চিত, আর এটা মাসের পর মাস এভাবেই পড়ে ছিল। নতুন rule যোগ করার আগে খুঁজে দেখুন কোন rule-এর সঙ্গে এর লড়াই বাধবে।
সব pointer মানা হয় না। ওপরের ভুল 1 বলছে সব কিছু ভেতরে না লিখে অন্য file-এর দিকে pointer দিতে, আর task দিয়ে চালু হওয়া read-এর ক্ষেত্রে সেটা খাটে। "Read docs/architecture.md before touching the sync flow" কাজ করে, কারণ task নিজেই trigger। কিন্তু একটা আচরণের rule on-demand file-এ সরিয়ে দেওয়া আলাদা ব্যাপার, আর সেটা সাধারণত কাজ করে না: কিছুই চালু হয় না, তাই কেউ সেটা পড়েও না। এভাবে সরিয়ে দেওয়া একটা rule 746টা session-এ একবারও পড়া হয়নি। কোনো rule-এর স্বাভাবিক trigger না থাকলে, হয় সব সময় load থাকা file-এ থাকার যোগ্যতা তার আছে, নয়তো সেটা মুছে ফেলুন।
দেখে নিন আপনার hook-গুলো আসলে সেই জায়গাটাই দেখছে কি না, যেটা আপনি ভাবছেন
এখানে সবচেয়ে কাজের পাঁচ মিনিট হলো আপনার settings.json পড়ে নিশ্চিত হওয়া যে প্রতিটা hook সেই জায়গার সঙ্গেই জোড়া, যেটা ঢাকার কথা সে দাবি করে। Write আর Edit-এর ওপর বসানো একটা PreToolUse hook কখনো chat reply দেখে না, তাই এভাবে চালানো rule শুধু file-এর ওপরই খাটে। Exit code-ও দেখে নিন: যে hook সমস্যা খুঁজে পেয়েও exit 0 দেয়, সেটা model-কে কিছুই ফেরত পাঠায় না, তাই তার খুঁজে পাওয়া জিনিস জমা হয় এমন একটা log-এ যা কেউ পড়ে না। Blocking hook-কে exit 2 দিতে হয়। বিস্তারিত দেখুন hooks guide-এ।
যে control আছে বলে আপনি বিশ্বাস করেন অথচ আসলে নেই, সেটা কোনো control না থাকার চেয়েও খারাপ, কারণ তখন আপনি খোঁজাই বন্ধ করে দেন।
বাস্তব একটা worked example
এখানে একটা আসল backend service-এর CLAUDE.md দেওয়া হলো: warehouse inventory সামলানো একটা gRPC service। gRPC হলো network-এর ওপর দিয়ে এক service থেকে আরেক service-এর function call করার একটা framework; আদান-প্রদান হওয়া data-র গঠন ঠিক করতে এটা JSON-এর বদলে proto file (Protocol Buffer file-এর ছোট নাম) ব্যবহার করে। Error handling-এ ব্যবহার হয় neverthrow, একটা TypeScript library যা exception throw না করে error-কে value হিসেবে ফেরত দেয়, ফলে প্রতিটা error path type system-এ দেখা যায়।
# CLAUDE.md

## Stack
- Node.js gRPC service. Proto files in /proto define all field names and types.
- TypeScript with neverthrow for error handling. Use Result<T, E>, not try/catch.
- Postgres via Drizzle ORM, migrations in /db/migrations.
- Deploy target: Fly.io

## Build & test
npm run build     # Compiles TypeScript and generates types from proto files
npm run test      # Runs Jest suite (must pass before any commit)
npm run gen       # Regenerates TypeScript types from .proto schema files

## Rules
- Errors: use ok() and err() from neverthrow. No try/catch in service logic.
- Never edit generated files under /proto/generated/. Change the .proto file, then run npm run gen.
- Functions under 50 lines. Files under 400 lines.
- Read docs/architecture.md before touching the inventory sync flow.
খেয়াল করুন এতে কী কী আছে: stack (প্রতিটা term-এর ব্যাখ্যা সঙ্গে সঙ্গেই), build আর test করার জন্য দরকারি command, আর যে rule-গুলো রোজকার output-এ প্রভাব ফেলে। Warehouse কী, সেটা এখানে ব্যাখ্যা করা নেই, Drizzle ORM-এর পুরো docs-ও paste করা নেই। সেগুলো থাকে docs/-এ।
Production-এ চলা একটা আসল CLAUDE.md
এটা শুধু তত্ত্ব না। এই নিন একটা আসল workspace structure, যা প্রতিদিন 6টা project জুড়ে চলে:
CLAUDE.md (index, ~80 lines)
├── _context/
│   ├── skills/         (19 workflow skills)
│   ├── agents/         (9 specialist agents)
│   ├── rules/          (10 coding rules)
│   ├── handoffs/       (session continuity)
│   └── memory/         (persistent knowledge)
├── .claude/
│   ├── commands/       (8 slash commands)
│   └── hooks/          (automation triggers)
└── memory/
    ├── MEMORY.md       (index)
    ├── user_*.md       (who you are)
    ├── feedback_*.md   (corrections)
    ├── project_*.md    (active work)
    └── reference_*.md  (external pointers)
প্রতিটা session শুরু হয় ১০ সেকেন্ডের কম সময়ে। কিছুই আবার বোঝাতে হয় না। গত মাসের correction এখনও খাটে। গতকালের handoff নিজে থেকেই load হয়।
Setup করতে মোটামুটি এক সপ্তাহ লেগেছিল। প্রতিদিন ৩০+ মিনিট বাঁচায়। ROI অবিশ্বাস্য রকমের বেশি।
শুরু করুন (৫ মিনিট)
প্রথম দিনেই এর সব কিছু লাগবে না।
এখনই: আপনার project-এ claude /init চালান। এটা আপনার codebase থেকে একটা basic CLAUDE.md বানিয়ে দেয়। কিছু না থাকার তুলনায় শুধু এটুকুই অনেক বড় উন্নতি। আগে থেকে test করা একটা file দিয়ে শুরু করতে চাইলে, Next.js, Python, monorepo বা PM workspace-এর জন্য CLAUDE.md templates থেকে একটা copy করে নিন।
এই সপ্তাহে: Communication preference আর একটা basic session lifecycle যোগ করুন (শুরুতে memory পড়া, শেষে handoff লেখা)।
এই মাসে: Pattern চোখে পড়তে থাকলে orchestration rule যোগ করুন। বারবার করা workflow-এর জন্য skill যোগ করুন।
System-টা আপনার সঙ্গে সঙ্গে বড় হয়। পুরো জিনিসটা শুরুতেই design করে ফেলার দরকার নেই। শুরু করুন, তারপর সময়ের সঙ্গে এটাকে জমতে দিন।
আপনার CLAUDE.md ঠিকমতো কাজ শুরু করলে, আর তার ওপরে agent আর cron job যোগ করতে থাকলে, পরের সমস্যা হলো দরকার না হওয়া পর্যন্ত এসব context-এর বাইরে রাখা। সেটার জন্য দেখুন subagent context-isolation pattern।
New guides, when they ship
One email, roughly weekly. CLAUDE.md templates, workflows I actually use, and the cut-for-length stuff that does not make the public guides. One-click unsubscribe.
Subscribe on SubstackOpens Product Field Notes, my Substack, in a new tab. You enter your email there.